字节推出Seed Audio 1.0音频创作模型:支持精准时序调控,字节作模准音色可控且长时段生成稳定
2026-07-22 17:00:11 来源:互联网 作者:xzwh
7月20日消息,推出字节跳动Seed正式推出音频创作模型Seed Audio 1.0。频创该模型面向全场景音频需求,型支序调在统一框架内对人声、持精长时成稳音效、控音控环境声等多种音频元素联合建模,段生定可端到端实现影视级音频创作。字节作模准
官方表示,频创声音不再局限于作为画面的型支序调辅助内容,还能够直接参与叙事,持精长时成稳在听众脑海中构建画面,控音控实现“听见”即“看见”的段生定效果,模型核心
能力如下:
多要素统一编排,字节作模准支持精细时间调控:依靠一条提示词就能统筹生成带情绪的对白、音效与环境声,并且能够沿着时间轴精准把控各类声音的出现时机。
音色风格可控,长时间生成保持稳定:支持文本输入与参考音频导入,在长音频以及多次续生成场景维持角色音色统一,同一个音色也可演绎不同语气情绪。
多语种自然生成:兼容20余种语种制作音频,同一角色语音能够贴合不同语种特点,呈现自然的发音、节奏与表达方式。
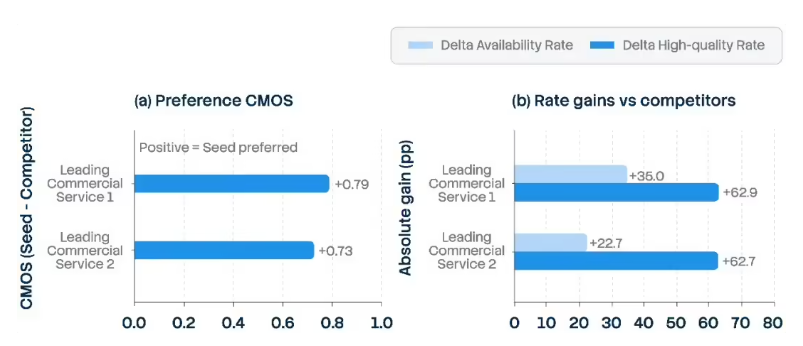
据介绍,在文本生成音色相关测试中,SeedAudio1.0在AB主观评测里优势突出,音频可用率与优良率均有明显提升。
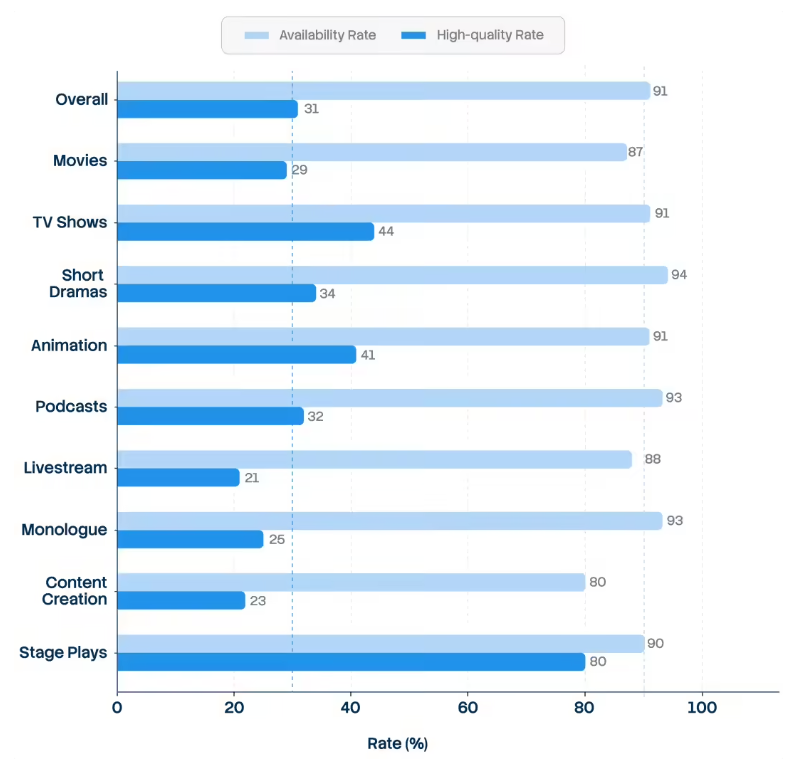
官方针对影视、短剧、动漫、播客对话、直播带货、网络创作、话剧、电视节目、语音合成等众多场景开展音频生成能力测试。测试结果表明,该模型在大部分场景下生成音频的可用率超过90%。
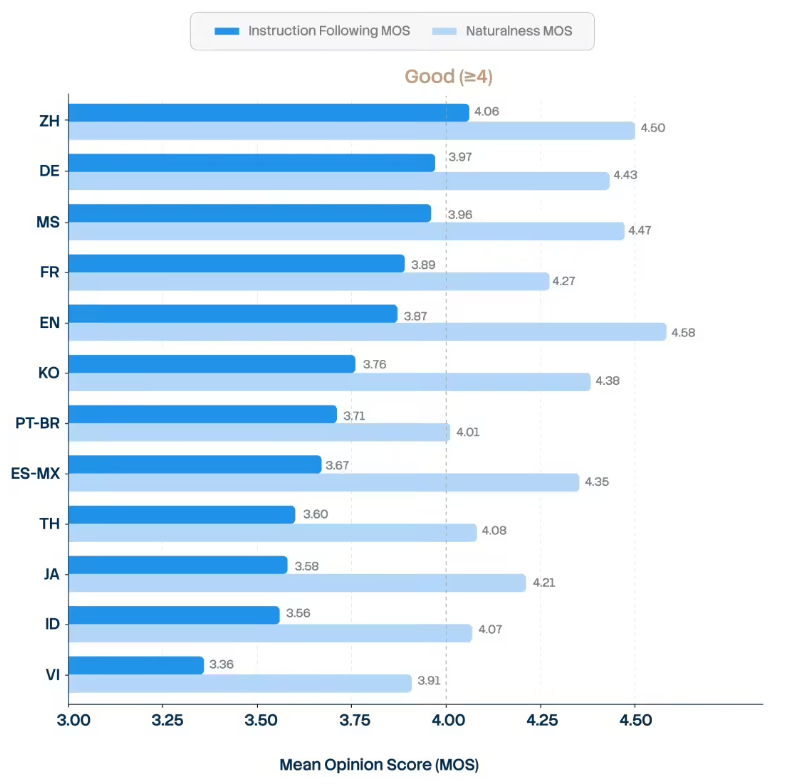
在多语言音频生成表现方面,音频自然度上,绝大多数语种MOS得分超过4分,音质表现优秀;复杂音频生成的指令遵从能力中,除越南语以外,其余语种MOS分数均高于3.5分,足以证明Seed Audio 1.0拥有出色的多语言指令理解能力。